让 Agent 复盘并优化模型路由
Codex 额度不够用、主力模型 token 消耗太快时,可以先让 Agent 看一遍已经完成的任务:哪些阶段确实需要主力,哪些普通步骤占了主力额度,经济模型做不好时有没有及时接手。HiRoute 把模型切换、判断依据、阶段评分和用量保存在同一套记录里,Agent 可以通过 CLI 复盘,再按你的目标调整路由。
这篇指南把一次大任务后的操作串起来:读记录 → 提炼难题 case → 改进决策提示词或信任度 → 发布后用新任务验证。目标是让主力额度支持更多能验收的工作;是否有效,要同时看质量、完成时间和费用。
还没配置路由,先看 Codex 接入教程或智能模型路由。本页的提示词和信任度调整适用于使用内置决策模型接入的难度路由;启发式规则没有胜任评分,自定义扩展的选组逻辑由扩展自己管理。
1. 开启管理技能,选一次已完成的任务
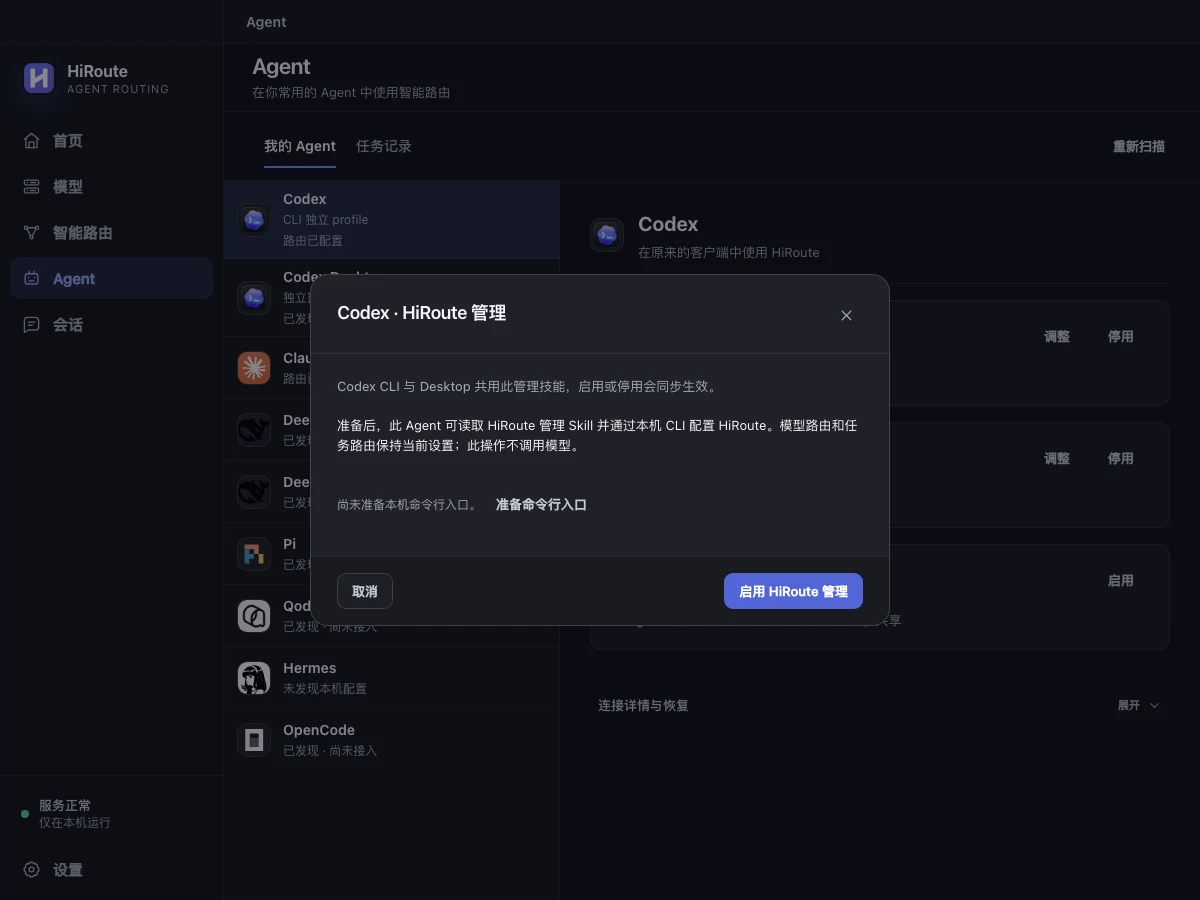
在 Agent → 常用 Agent → HiRoute 管理中启用管理技能,按提示准备命令行入口并重新加载技能或开启新会话。图形界面和 CLI 连接同一个 HiRoute 服务,Agent 读到的配置与执行记录,也能在界面里查看。
选一个已经完成、验收结果明确的大任务,例如修复一个缺陷并补齐回归。先给 Agent 这句话:
使用 HiRoute 管理技能,复盘刚完成的这个任务。检查每次模型切换的理由、主力承担的步骤、经济模型遇到的问题,以及测试和我的反馈。先给我 3 个最值得改进的地方,每个都附记录依据和验证办法。
希望找一周内的典型问题时,可以从下面的只读入口开始,再按本机帮助限定实际路由或会话:
hiroute sessions list --view switches --period 7d --output json
关联费用与内容查询时复用返回的 analysis_scope,保持相同范围,并按 next_cursor 继续读取。不要把第一页当全部记录,也不要把不同范围的费用相加。具体查询方式见 CLI 会话与费用分析。
2. 从路由时间线里找出值得改进的阶段
在 会话 → 路由时间线中选中一个阶段,看当时的判断、实际执行模型和后续评分;需要理解任务时再进入“对话”。Agent 可以读取对应的 CLI 记录,把这些事实放到一起分析。
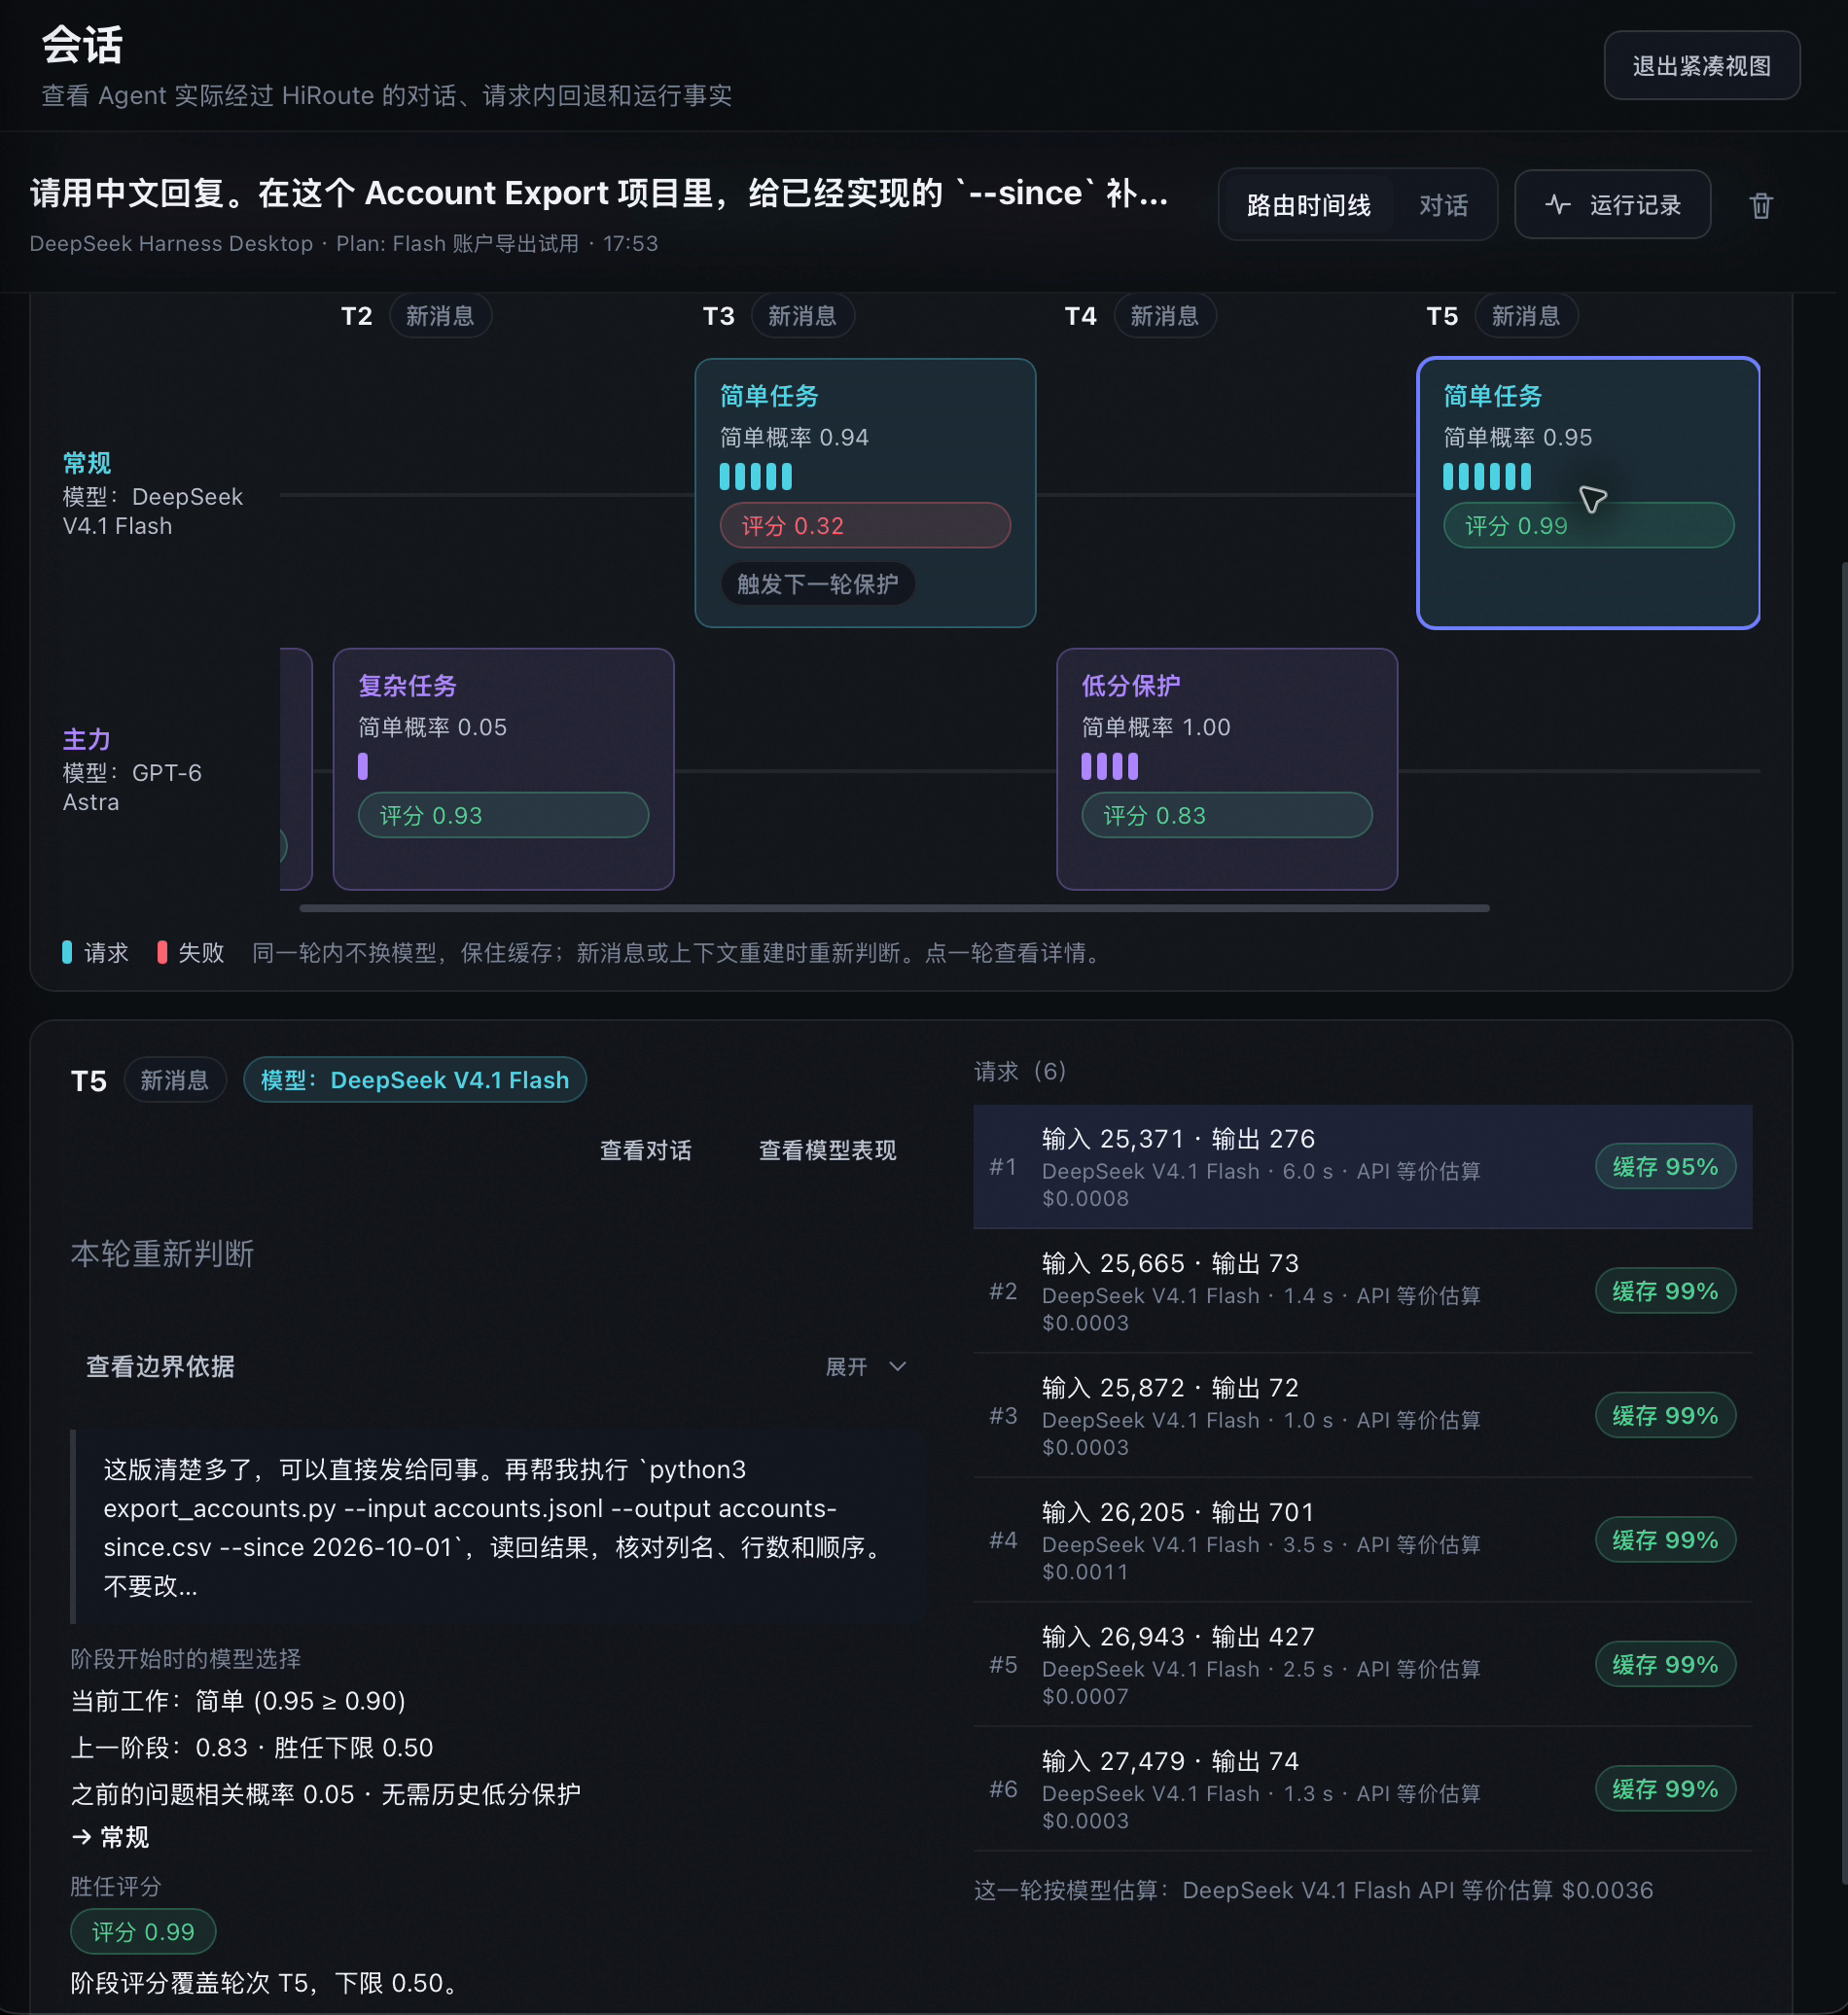
复盘时至少区分三件事:当时为什么这样选、模型实际做了什么、后来怎样评价它。后续评分不能倒过来当作当时已有的证据;低分保护切到主力,也可能是一次正确的接手。
| 记录里看到的情况 | 先核对什么 | 值得尝试的调整 |
|---|---|---|
| 方案已经确定,只补局部回归,仍频繁使用主力 | 是否还存在未解决的根因、跨模块影响或低分保护 | 在难度提示词中写清“已有可靠方案、边界明确”的常规工作 |
| 经济模型反复修改,验收仍失败 | 阶段评分是否完整、失败是否与下一步相关、是否触发保护 | 明确验收失败与返工的评分标准,检查决策可见证据 |
| 并发状态隔离、资源生命周期等问题被当成普通改动 | 判断是否只看改动文件数或任务里的关键词 | 补充这个项目真正复杂的边界与风险 |
| 经济模型连续完成多类任务 | 样本是否来自多个会话、评分覆盖是否足够 | 先回放更高信任度,再用新任务验证 |
| 费用高,但模型切换没有明显问题 | 重试、长上下文、工具往返、缓存和委派开销 | 分析执行方式,必要时参考跨 Agent 委派 |
让 Agent 为每个候选 case 记录:任务与验收目标、会话和阶段、当时模型与标准、关键反馈、交付结果,以及为什么建议修改。保留顺利完成的例子,才能知道哪些规则已经合适。
没有评分不等于零分,内容缺失也不证明选模有错。判断依据不足时,先补足记录或积累更多任务。
3. 分别优化难度提示词和胜任评分标准
在智能路由中打开目标路由进行编辑,展开判断设置。这里的两类提示词回答不同的问题:
- 什么是简单、复杂任务:判断当前阶段适合常规还是主力。
- 如何判断胜任:评价上一阶段做得怎样,包含评分要求和 0 / 0.5 / 1 标准。
让 Agent 从 case 中提炼项目规则,每条规则说明可观察的条件。下面是工程维护项目的写法示例,采用前要结合自己的记录验证。配置时,将难度规则分别放到“判断要求”“简单任务”“复杂任务”,将评分说明和三个分值标准放到各自字段。
难度判断要求示例:
按当前阶段需要解决的问题判断难度,不因项目使用 Rust、文件较长或任务名称含“重构”就直接判为复杂。
常规:定位已知符号、整理已找到的证据、在根因和方案已明确且边界局部时补实现或回归测试。
复杂:根因尚不明确的跨模块缺陷、并发请求状态隔离、内存所有权或资源生命周期、协议兼容性、需要在多个设计之间取舍。
补测试前仍需推导并发时序或正确性边界时,按复杂阶段处理。主力完成定位后,后续已明确的局部工作重新按实际难度判断,不沿用整个大任务的复杂标签。
胜任评分要求示例:
按上一阶段承诺的目标评价,并引用可见证据。阶段只负责调查时,不因尚未实现代码而扣分;阶段承诺交付时,检查验收是否完成。
0:有明确证据表明关键目标未完成、修复无效或引入影响目标的回归,仍需重新处理。
0.5:完成了部分目标,但有已知的重要遗漏或需返工之处。
1:完成本阶段目标,相关验收证据支持结论,已知问题已处理或按任务约定交接。
缺少测试结果、记录不完整或结论无法核对时,说明证据不足,不把“没有看到报错”当成通过。识别用户指出的具体未满足要求,区分它与新增需求。
不要为了让经济模型分数好看而降低验收要求。 代码任务仍要跑对应测试;界面任务需要实际操作时,保留 Computer Use 验收;关键方案继续由人参与。
决策模型只能评价收到的历史。HiRoute 内置判断不会把工具参数和工具结果正文直接发送给决策服务;可以要求执行 Agent 在阶段结束时如实概括验收命令、结果与尚未解决的问题,让这些信息进入可见回答。提示词不能补出缺失的证据。详见决策模型与路由机制。
4. 回放信任度,决定交给经济模型多少工作
如果判断标准基本合适、常规模型也表现稳定,再考虑调整 信任度 · 交给常规模型的程度。越往右,实际的简单概率阈值越低,更多阶段有机会交给常规模型。它不是固定分配比例,也不是执行成功率。
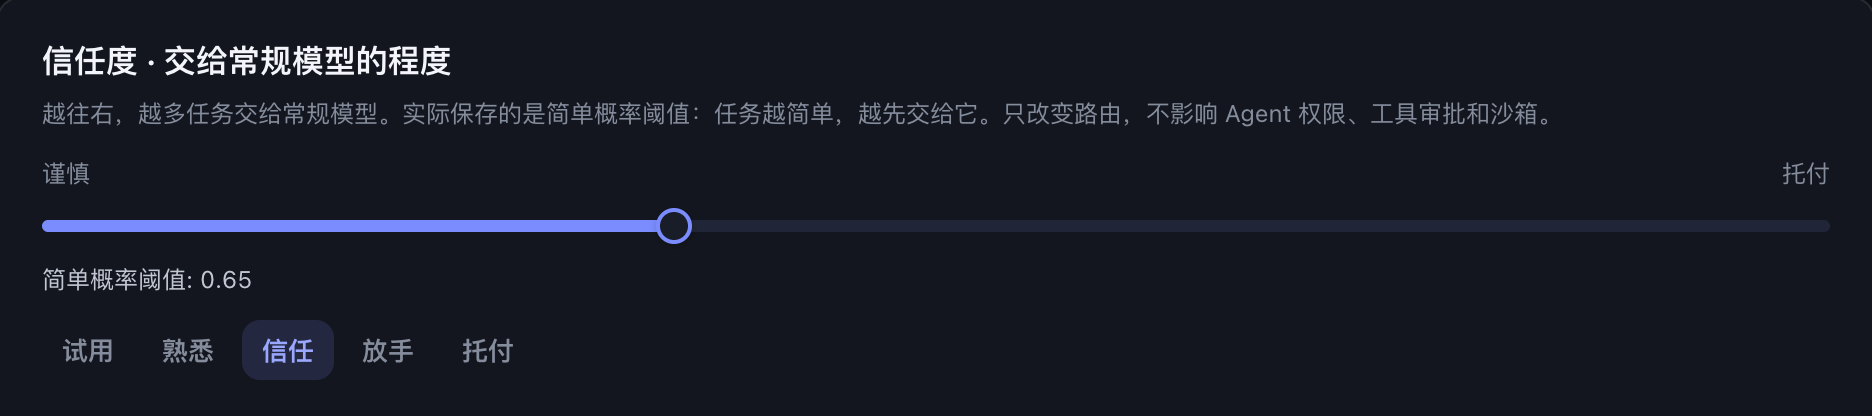
编辑已有路由时,查看下方的 用你的记录回放此设置:用当前发布版本最近 7 天的记录估算分配变化。CLI 也能比较几个候选阈值,例如:
hiroute observation plan-trust replay --plan-id PLAN_ID --revision active --thresholds-millis 800,700,600 --output json
用实际计划 ID 替换 PLAN_ID。这里的 800、700、600 分别表示 0.8、0.7、0.6,并非推荐值。CLI 回放范围以实际请求和返回结果为准,不自动等同于界面的最近 7 天;对比时保持相同版本、时间与分支。
回放使用已有判断,不调用模型。它能估算换一个阈值后历史阶段会怎样分配,不能重算新提示词的判断,也不能证明新交给经济模型的工作一定能做好。 改过提示词后要用新任务积累记录。
简单概率阈值与胜任下限是两回事。提高信任度时仍保留适用的低分保护;信任度也不改变 Agent 的权限、工具审批或沙箱。证据不够时保持当前设置即可,试用新模型说明了内置信任建议的条件。
5. 发布一次小改动,用后续任务验证
让 Agent 给出可审阅的改动,例如“只补充并发缺陷的难度条件”或“提示词不变,仅尝试一个相邻信任档位”。一次改一类因素,更容易知道变化来自哪里。
已授权应用时,让它按管理技能保存完整计划及恢复材料,使用 routing preview 检查差异,再通过 routing apply 发布。界面中对应“发布更改”;保存草稿不会影响当前路由。保留原来的模型候选、推理设置和其他不相关配置。
用后续相近任务验证,记录发布版本,并比较:
| 维度 | 要看什么 |
|---|---|
| 交付质量 | 测试、Computer Use 或人工验收是否通过;返工与未解决问题 |
| 主力使用 | 哪些阶段进入主力,哪些触发低分保护,普通阶段是否合理回到常规 |
| 完成效率 | 完整交付时间,包含失败、重试和验收所用时间 |
| 用量与费用 | 输入、输出、缓存、价格覆盖;已计入与尚未计入的决策和复盘开销 |
hiroute value show 可以辅助算账;API 等价费用用于比较模型使用的估算成本,不能直接换算成 Codex 周额度节省比例或订阅账单下降。没有单价的记录保持未知;复盘本身也会消耗 Agent 的 token。先分析一次任务的摘要和异常阶段,有必要时再读相关对话。
可以把这句话作为以后每次大任务的收尾:
使用 HiRoute 管理技能复盘这次任务。给我质量、完成时间、模型切换和费用的简要结论;有充分依据时,提出一项提示词或信任度改进,并说明下一次怎样验证。没有足够证据就保留当前设置。
常见问题
Codex 周额度不够用,应该先改什么?
先检查主力是否在做大量边界明确的普通步骤,再看是否存在返工、无效工具往返和反复搬运上下文。模型分流优化主力额度的使用方式;HiRoute 不改变订阅本身的额度上限。需要接入其他模型时,参考 Codex 模型路由和 Qoder 模型接入。
Agent 会自动学习并修改决策提示词吗?
默认不会。Agent 可以读取记录、提炼案例并提出改动,在你授权后通过管理技能应用。HiRoute 的内置信任建议也不会自动发布。让 Agent 自己复盘,是把分析与配置交给 Agent 完成,仍然需要明确的目标、权限范围和验收。
改了提示词,历史评分会重新计算吗?
不会。历史记录保留当时的配置和标准,阈值回放也不会调用决策模型重评。新提示词发布后的效果,需要在新任务中观察。
能不能只提高经济模型的信任度?
可以把它作为一个独立实验,但先检查判断标准与评分覆盖。如果问题来自并发任务被误判,单独提高信任度可能扩大误判;先修正具体判断条件,再验证更合适。
接下来:智能模型路由 · 试用新模型 · CLI 查询与恢复 · 跨 Agent 委派