使用智能模型路由
智能模型路由让 Agent 使用你配置的一组模型。固定模型和免费优先按候选顺序尝试;按难度分流根据任务复杂度选择常规或主力模型,自定义分支还会先区分写稿、审稿等任务类别。修改配置后,需要发布才能处理新请求。
按难度分流和自定义分支会在每条新用户消息到来时重新判断。同一轮内,Agent 调用工具后继续工作时,通常沿用本轮已经选定的模型组;具体条件见下文“理解本轮选择与失败处理”。
重新判断后仍选中同一模型组时,只要对话记录仍能衔接、原模型仍满足请求要求,HiRoute 就会优先沿用上一轮的模型,包括此前自动切换到的备用模型。这有助于延续模型上下文并复用提示词缓存。选中不同组,或原模型不能继续使用时,会按正常规则选择和自动切换。这个行为自动生效,无需设置追问开关。
下面以桌面应用说明配置,Linux Web UI 的界面和操作相同。也可以用 CLI 的 routing options/list/show/preview/apply 和 decision services list/apply/test 配置相同功能,具体步骤见 Linux 安装 和 HiRoute CLI;请求字段以当前安装返回的 schema(请求和响应的结构说明)为准。第一次接入可按 快速开始 创建固定模型路由,随后再配置决策模型。想让一个新模型先承担简单工作、由主力兜底,可以直接按 试用新模型 操作。
选择路由类型
在“智能路由”中创建或编辑一份计划,在“怎样使用模型”中选择:
| 类型 | 适合什么情况 | 行为 |
|---|---|---|
| 固定模型 | 需要可预测的候选顺序 | 按顺序尝试候选,跳过能力不满足或暂时不可用的模型 |
| 按难度分流 | 希望把简单任务交给更便宜的常规模型来降低成本,复杂任务使用主力 | 根据本轮复杂度判断及适用的上一阶段评分,选择常规或主力模型组 |
| 自定义分支 | 写稿、审稿等任务需要不同模型 | 先选择任务类别,再在该分支内选择常规或主力模型组 |
| 免费优先 | 希望优先使用免费模型 | 按固定顺序尝试免费候选,可选择停止或进入主力兜底 |
“模型 → 通用模型”管理实际执行任务的模型。“模型 → 决策模型”管理用于判断和评分的模型连接,以及自行部署的自定义扩展。决策模型负责判断和评分,通用模型负责回答用户、调用工具和完成任务。
连接决策模型
- 打开“模型 → 决策模型”,选择“添加决策模型”。
- 在“凭据”中选择来源。“使用已有 API 接入”复用“模型”中已保存接入的 Key,无需再次填写;“独立配置”需要先选择供应商,再为决策模型单独填写 Key。供应商支持百炼(Token Plan 或业务空间)、OpenAI、OpenRouter、TypeSafe,以及“其他兼容接入”。
- 确认模型 ID、完整地址和协议,并填写名称。已有预填可选择“更改”修改,未预填则直接填写。
- 选择“保存并测试”,或先“仅保存”,再在详情中选择“测试连接”。
使用内置接入时,HiRoute 直接把判断问题发送给供应商的决策模型,并将结果用于路由。你不需要另外部署 Jev 服务。
“上下文窗口”默认自动,按模型元信息确定,也可以自定义总窗口。当前输入和决策问题优先保留,剩余空间用于历史;“高级:单个问题上限”可以单独限制每个问题的长度。
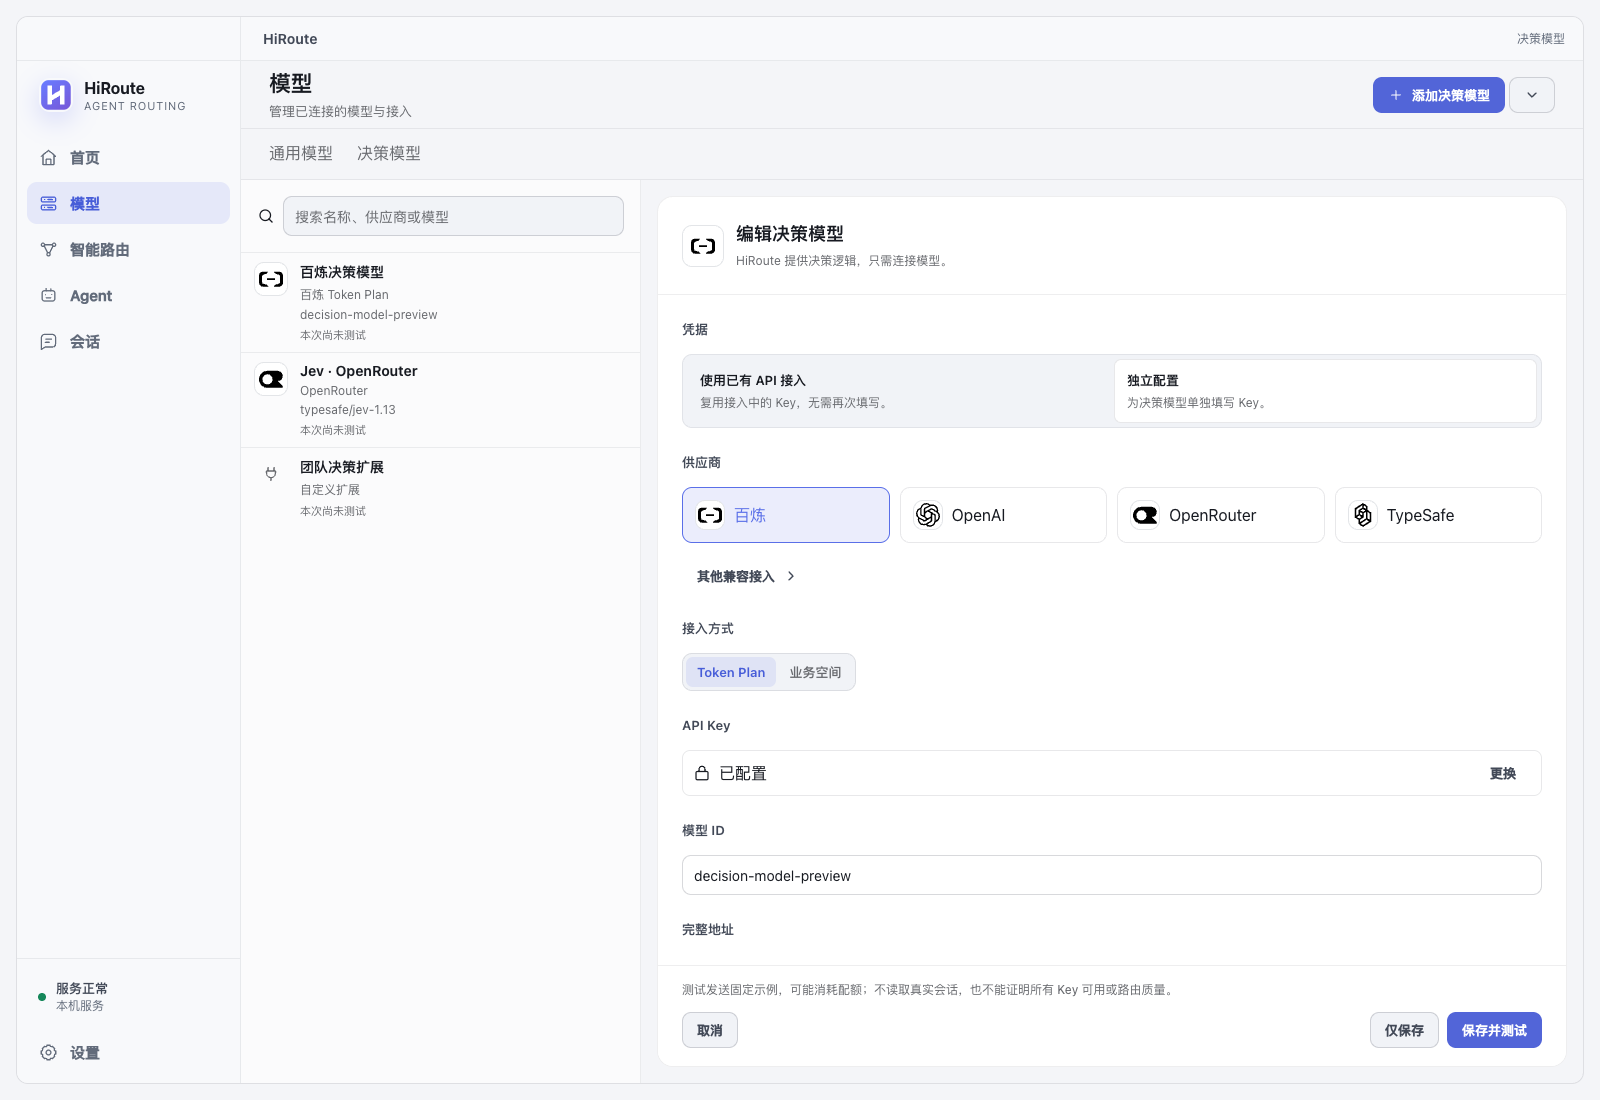
“保存并测试”会先保存连接,再用固定示例检查它能否返回符合要求的结果。测试可能消耗供应商额度,但不会读取你的真实会话。测试通过表示这次连接可用,实际判断效果仍需通过任务观察。测试失败不代表保存失败,请查看详情中的状态后修改或重试测试。
每次编辑保存都产生一个新版本。已发布路由继续使用原来选定的版本;例如连接从 r1 更新为 r2 后,需要在路由中选择 r2 并发布更改才会切换。仅保存连接或测试连接不会发布路由。从未完成的路由中新增连接,会保留原草稿,返回后仍需主动发布。使用已有 API 接入时,接入中的 Key 或网络设置变化会直接用于之后的调用,无需重新发布;更改模型、地址或协议则会生成新版本。
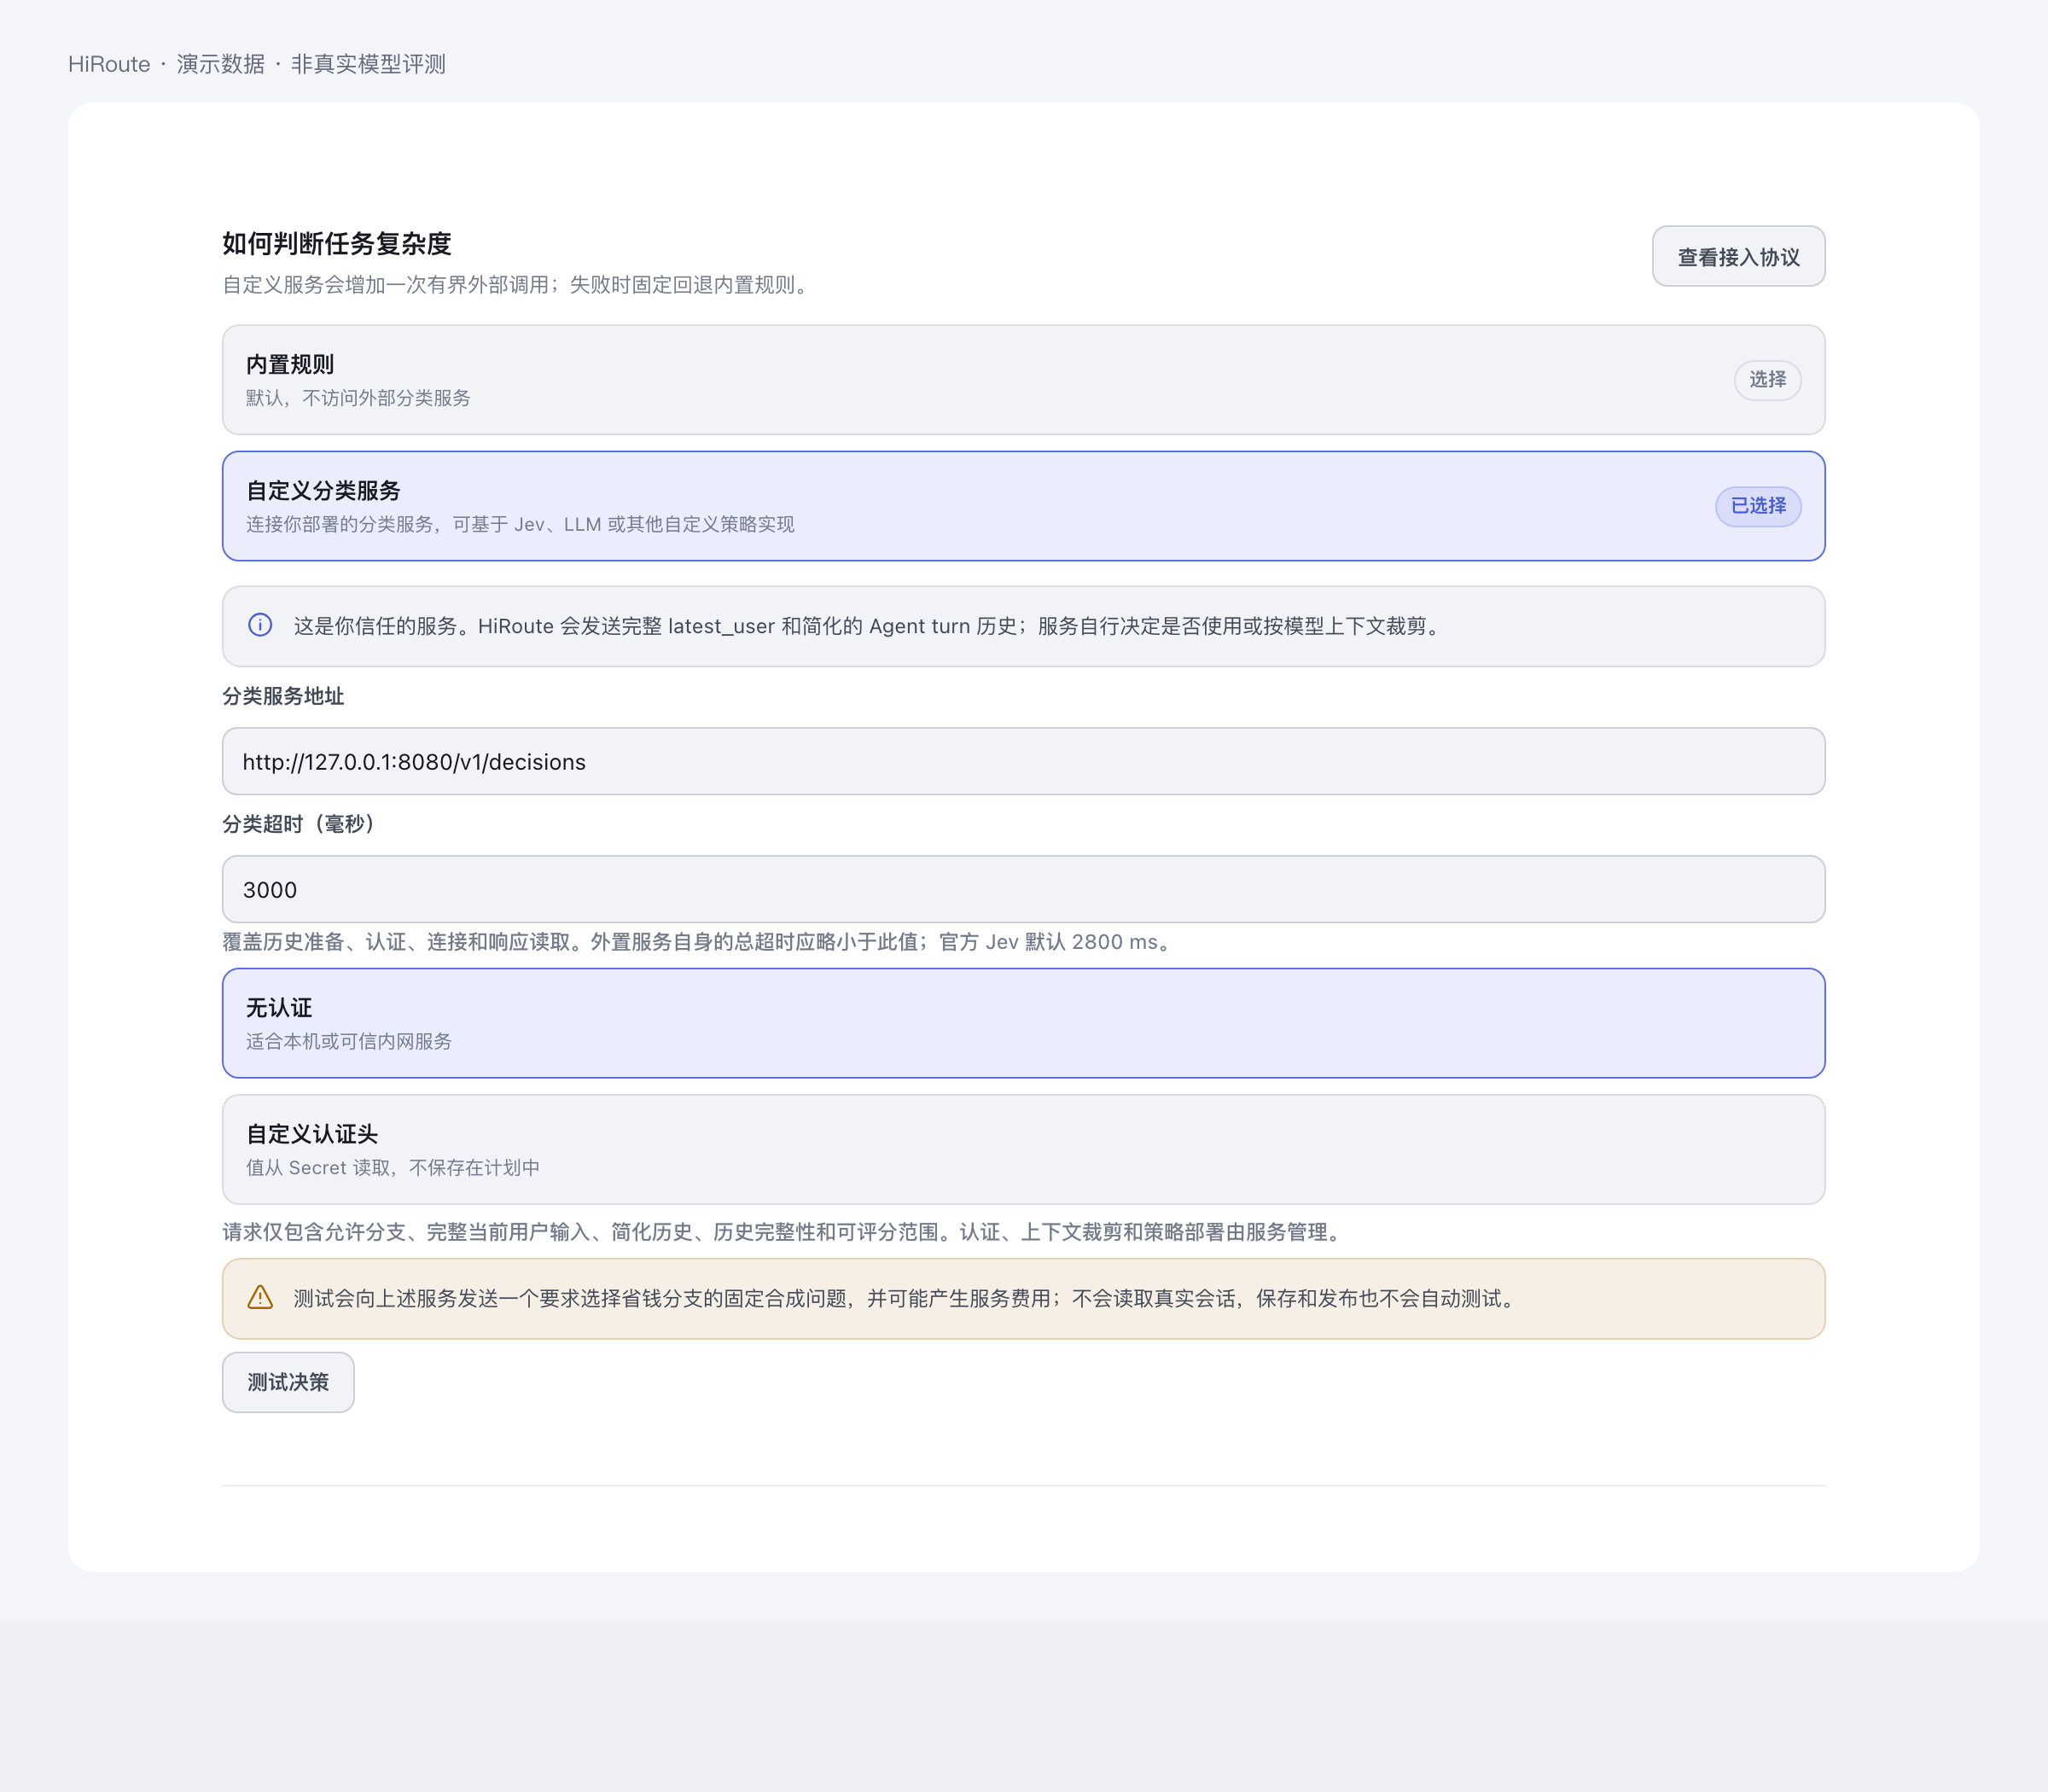
需要由自己的服务选择类别和模型组时,可在新增菜单中选择“接入自定义扩展”,填写完整 endpoint(请求地址)并选择认证方式。扩展遵守 自定义扩展 API;内置供应商配置和接口映射见 决策模型接入指南。可选的 Jev 自托管参考扩展 提供自行部署的示例。
实际路由判断会把当前用户的完整输入和保留的执行历史发送给所选决策服务。历史包含用户内容、已接收的模型回答、工具名称、执行顺序,以及协议明确报告的工具状态;不包含系统或开发者提示词、工具参数、工具结果正文和执行模型凭据。上一阶段按执行时保存的标准评分,缺少的历史证据也会标记出来。
配置按难度分流
选择自定义扩展后,无需配置下述信任度与判断设置。扩展自行选择模型组;编辑器仅显示类别、条件和候选,切回内置连接时恢复已保留的判断设置。
- 选择“按难度分流”。“判断方式”默认使用决策模型,选择刚保存的连接版本;也可主动选择“启发式规则”或“自定义扩展”。
- 在“常规模型”中加入处理要求明确、范围有限任务的模型。
- 在“主力模型”中加入处理复杂任务、或在上一阶段表现不佳时接手的模型。
- 每组用“添加模型”逐个加入候选,调整上下顺序;需要时打开模型的思考设置,应用或取消修改。
使用决策模型时,“信任度 · 交给常规模型的程度”决定多少任务交给常规模型:越往右,越多任务交给常规模型。可以点选“试用、熟悉、信任、放手、托付”五个档位,也可以在“精确值”中填写。实际保存的是简单概率阈值,任务越简单越先交给常规模型;新计划默认“熟悉”,阈值 0.8。“托付”对应阈值 0,此时适用的低分保护仍然生效。信任度只改变路由,不影响 Agent 权限、工具审批和沙箱。
编辑已有路由时,信任度下方会显示“用你的记录回放此设置”:用当前发布版本最近 7 天的记录,估算新设置下有多少阶段会交给常规模型。这是对历史分配的估算,不是对未来的预测。证据足够时,首页还会给出上调或下调的建议,见 试用新模型。
“判断设置”默认收起,胜任下限默认为 0.5。展开后可修改“什么是简单、复杂任务”的判断要求,以及“如何判断胜任”的评分要求和 0 / 0.5 / 1 三个评分标准。如果上一阶段的完整评分适用于本轮任务、且低于胜任下限,本轮会使用主力模型。
简单概率表示决策模型认为当前任务符合“简单”条件的可能性。例如返回 0.9,表示它更倾向于判为简单,并不表示执行模型有 90% 的成功率。
启发式规则只根据任务特征判断简单或复杂,不产生模型胜任评分,因此不显示信任度或评分提示词。切换判断方式再返回,会保留原来的连接及判断设置草稿。
配置自定义分支
选择“自定义分支”,例如分别为写稿和审稿安排模型。默认提供两个分支,可以按需添加:
- 给每个分支填写名称和“任务条件”,如“根据资料起草或改写文章”“审阅现有文章并提出修改意见”。条件描述任务类别;简单和复杂的标准在“判断设置”中填写。
- 加入“常规模型”。需要两档时,选择“添加主力模型(可选)”并加入候选。只配常规组的分支不判断复杂度,仍可记录胜任度用于观察。
- 在计划底部展开“计划默认判断设置”,配置共用的阈值、复杂度条件与评分标准。
- 分支默认跟随计划。需要不同标准时,展开该分支的“判断设置”并选择“单独调整”;要重新跟随计划,选择“恢复计划默认”。
有主力组的分支各有一个“信任度”控件。在分支上调整信任度,这个分支会改用单独的判断设置。
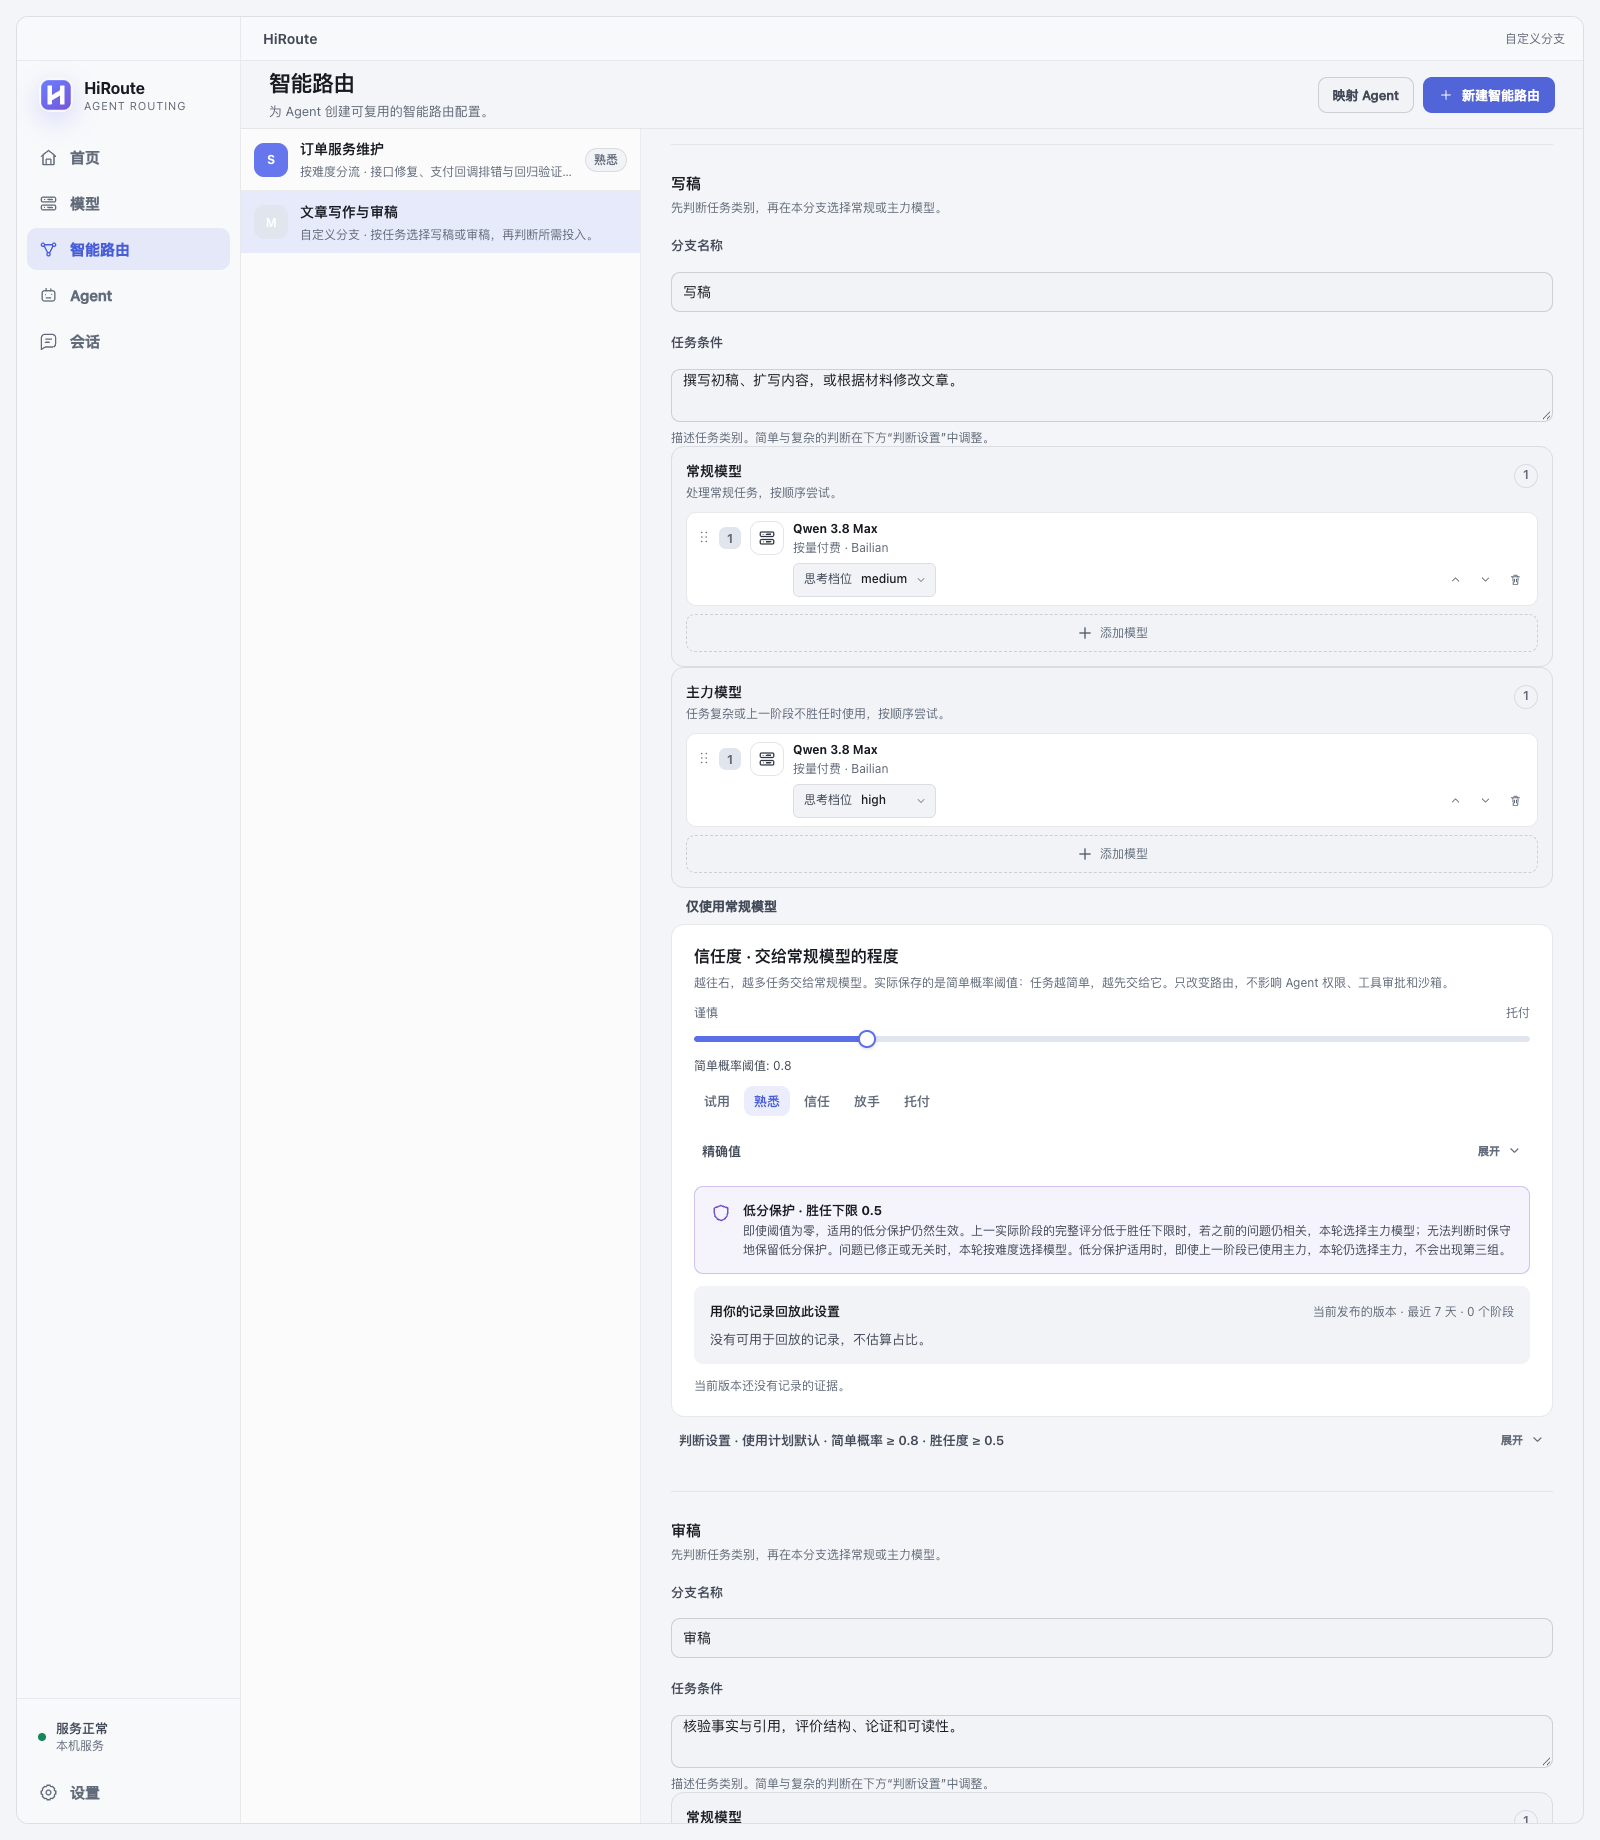
“单独调整”会复制计划当前的阈值、复杂度判断要求和胜任标准;之后修改计划默认设置,不再影响这个分支。“恢复计划默认”会移除这份独立设置,让分支重新跟随计划,同时保留它的名称、任务条件和模型。没有主力的分支只展示胜任设置;添加主力后才出现复杂度设置。
每次只选择一个任务分支。条件重叠时按当前主要意图选择;均不匹配时使用单独配置的“默认分支”,继续使用该分支的复杂度判断。写稿低分仍属于写稿阶段,不能因为本轮改为审稿就触发审稿主力。
理解本轮选择与失败处理
使用决策模型时,每条新消息到来,决策模型都会沿任务时间线独立回答三个问题:上一步做得怎么样(胜任分)、这一步有多难(简单概率)、上一步的问题会带进下一步吗(之前的问题相关概率)。阈值、选组和执行由 HiRoute 按你的路由设置负责。
在按难度分流和自定义分支中,对于有两组模型的任务,只有本轮简单概率达到阈值、且没有适用低分时,才使用常规组;否则使用主力。按新计划的默认设置,简单概率达到 0.8 才算达标;胜任分达到 0.5 即达标,低于 0.5 才触发保护。
用于低分保护的评分必须由本次决策返回,评价上一实际执行阶段,并有完整证据。上一阶段与本轮还必须使用相同任务类别、发布版本和评分标准。缺失、部分证据、跨分支或无法归属的评分不能触发保护;未评分不等于零,旧低分也不会反复生效。
难度有效时,简单和复杂任务都会独立评估符合条件的低分。之前的问题相关概率低于 0.5,表示上一步的问题不会带进这一步:此时只解除历史约束,仍按难度选择模型,因此复杂任务继续使用主力;相关概率不可用时保留保护。上一实际阶段使用主力也可触发保护,但不会出现第三组。
新的可用请求可以重新选择,上一轮使用主力不会锁定后续轮次。工具续接在原生证据能够识别同一任务、已有决策仍可复用时继承选择。已识别的摘要和辅助请求不进入主任务历史。
智能路由不以完美证明“User 来自真人”为前提。来源不确定时,HiRoute 对实际可见输入分类,捕获实际接受的执行结果,并标注来源未知,继续进行跨轮次质量评价。这些请求使用与已验证适配器输入分开的历史。分类确实失败时可以临时按计划回退,但不会因此停用后续正常请求。
Gateway 重启会丢失内存中的执行历史。下一个可用请求可以在原会话重新开始捕获,包括已经压缩的 Codex 线程;不会用旧摘要回填实际执行。后续问题可以评价新捕获的执行,较早未捕获的上下文仍标为部分历史。
来源和评分限制与路由持续可用分开记录:
- Claude Code、Hermes 可能把合成通知作为 User 输入。这些会记录为来源未知的实际请求,不宣称是真人任务;任务关联与评分仍可能有误差。
- Qoder 无法可靠区分共享身份的主会话、子任务和后台请求。接受这项关联限制,同时保留分类、选模、历史和评价。
- Pi、DeepSeek Harness、OpenCode 的原生适配器提供更强的任务边界。可选来源信息缺失或读取失败时,可以按实际可见输入继续路由;重新应用连接可安装当前适配器。明确标识的合成续接仍不能替代丢失的原任务。
- 不透明 peer 内容、未知原生生产者版本不能证明输入来源或模型缓存连续性,但不会让可用请求长期停用智能路由。
真实 A→B 验收必须证明两问都有有效分类和历史捕获、B 评价 A 的实际执行,并实际选中不同模型组。只看到回答成功或历史为空并不足够;这些持续可用性结果也不代表评分准确性已经验证。
组内模型按你设置的顺序尝试,这就是故障接力。常规组候选都无法使用时,再尝试同一任务分支的主力组;主力组也无法使用时,请求失败。直接选中主力时只尝试主力候选,不降回常规或跨任务分支;单组分支在本组耗尽后失败。候选调用失败不等于不胜任,不会因此生成零分。
实际输入可用时,若双组分支的任务类别有效但复杂度结果不可用,使用该分支主力并记录复杂度判断失败。整体决策失败时,按难度分流使用启发式规则,自定义分支使用默认分支的主力组(只有一组则使用常规组)。已识别为摘要且没有独立任务的请求,不会通过启发式规则获得真人来源证明。
所有候选都必须满足请求所需的文本、图片、工具和上下文能力。开始向客户端交付回答后,HiRoute 不会在同一回答中悄悄换用另一个模型。
发布并连接 Agent
选择“启用”或“发布更改”后,HiRoute 会保存本次生效的连接版本、任务条件、判断设置、模型顺序及思考配置。之后编辑草稿不会立即影响正在使用的配置。无模型、缺连接或非法判断设置会阻止发布;隐藏在收起区域中的问题会展开定位。
随后在“Agent”页面选择目标 Agent,在“模型路由”中启用,选择这条路由,并按页面提示重新加载 Agent。各 Agent 的接入方式见 快速开始。保存后,提交一个小任务验证模型入口。
路由的“上下文与等待时间”:
- 上下文窗口:默认自动,最多使用 400,000 tokens,并受所有候选的共同上界约束;也可以自定义。较大的窗口可能增加上下文和缓存费用。
- 单次请求最长等待(秒):包含请求内重试和流式输出,新计划默认为 1 小时。慢速长回复到达该时限会被中断;请求写入、等待首包和响应流空闲阶段各默认为 10 分钟。已有计划保留原值。这不改变模型自身的最大输出长度。
- 允许 Codex 并行工具调用:在“高级设置”中,默认开启;模型不支持时可以关闭,HiRoute 会在请求中禁用并行调用。
修改并发布后,已接入的 Agent 需要重新保存模型设置并重新启动,才能加载新的窗口和工具调用能力。
查看实际效果
在“会话”中打开一个会话,“路由时间线”按轮次展示每一轮实际使用的模型组和模型、简单概率与阶段评分,以及低分保护在哪一轮触发、在哪一轮解除。选中一轮,可以看到这一阶段开始时的选择依据,以及每个请求的用量、缓存命中和 API 等价估算;“查看对话”切换到对话内容,“查看模型表现”打开这条路由的模型表现。
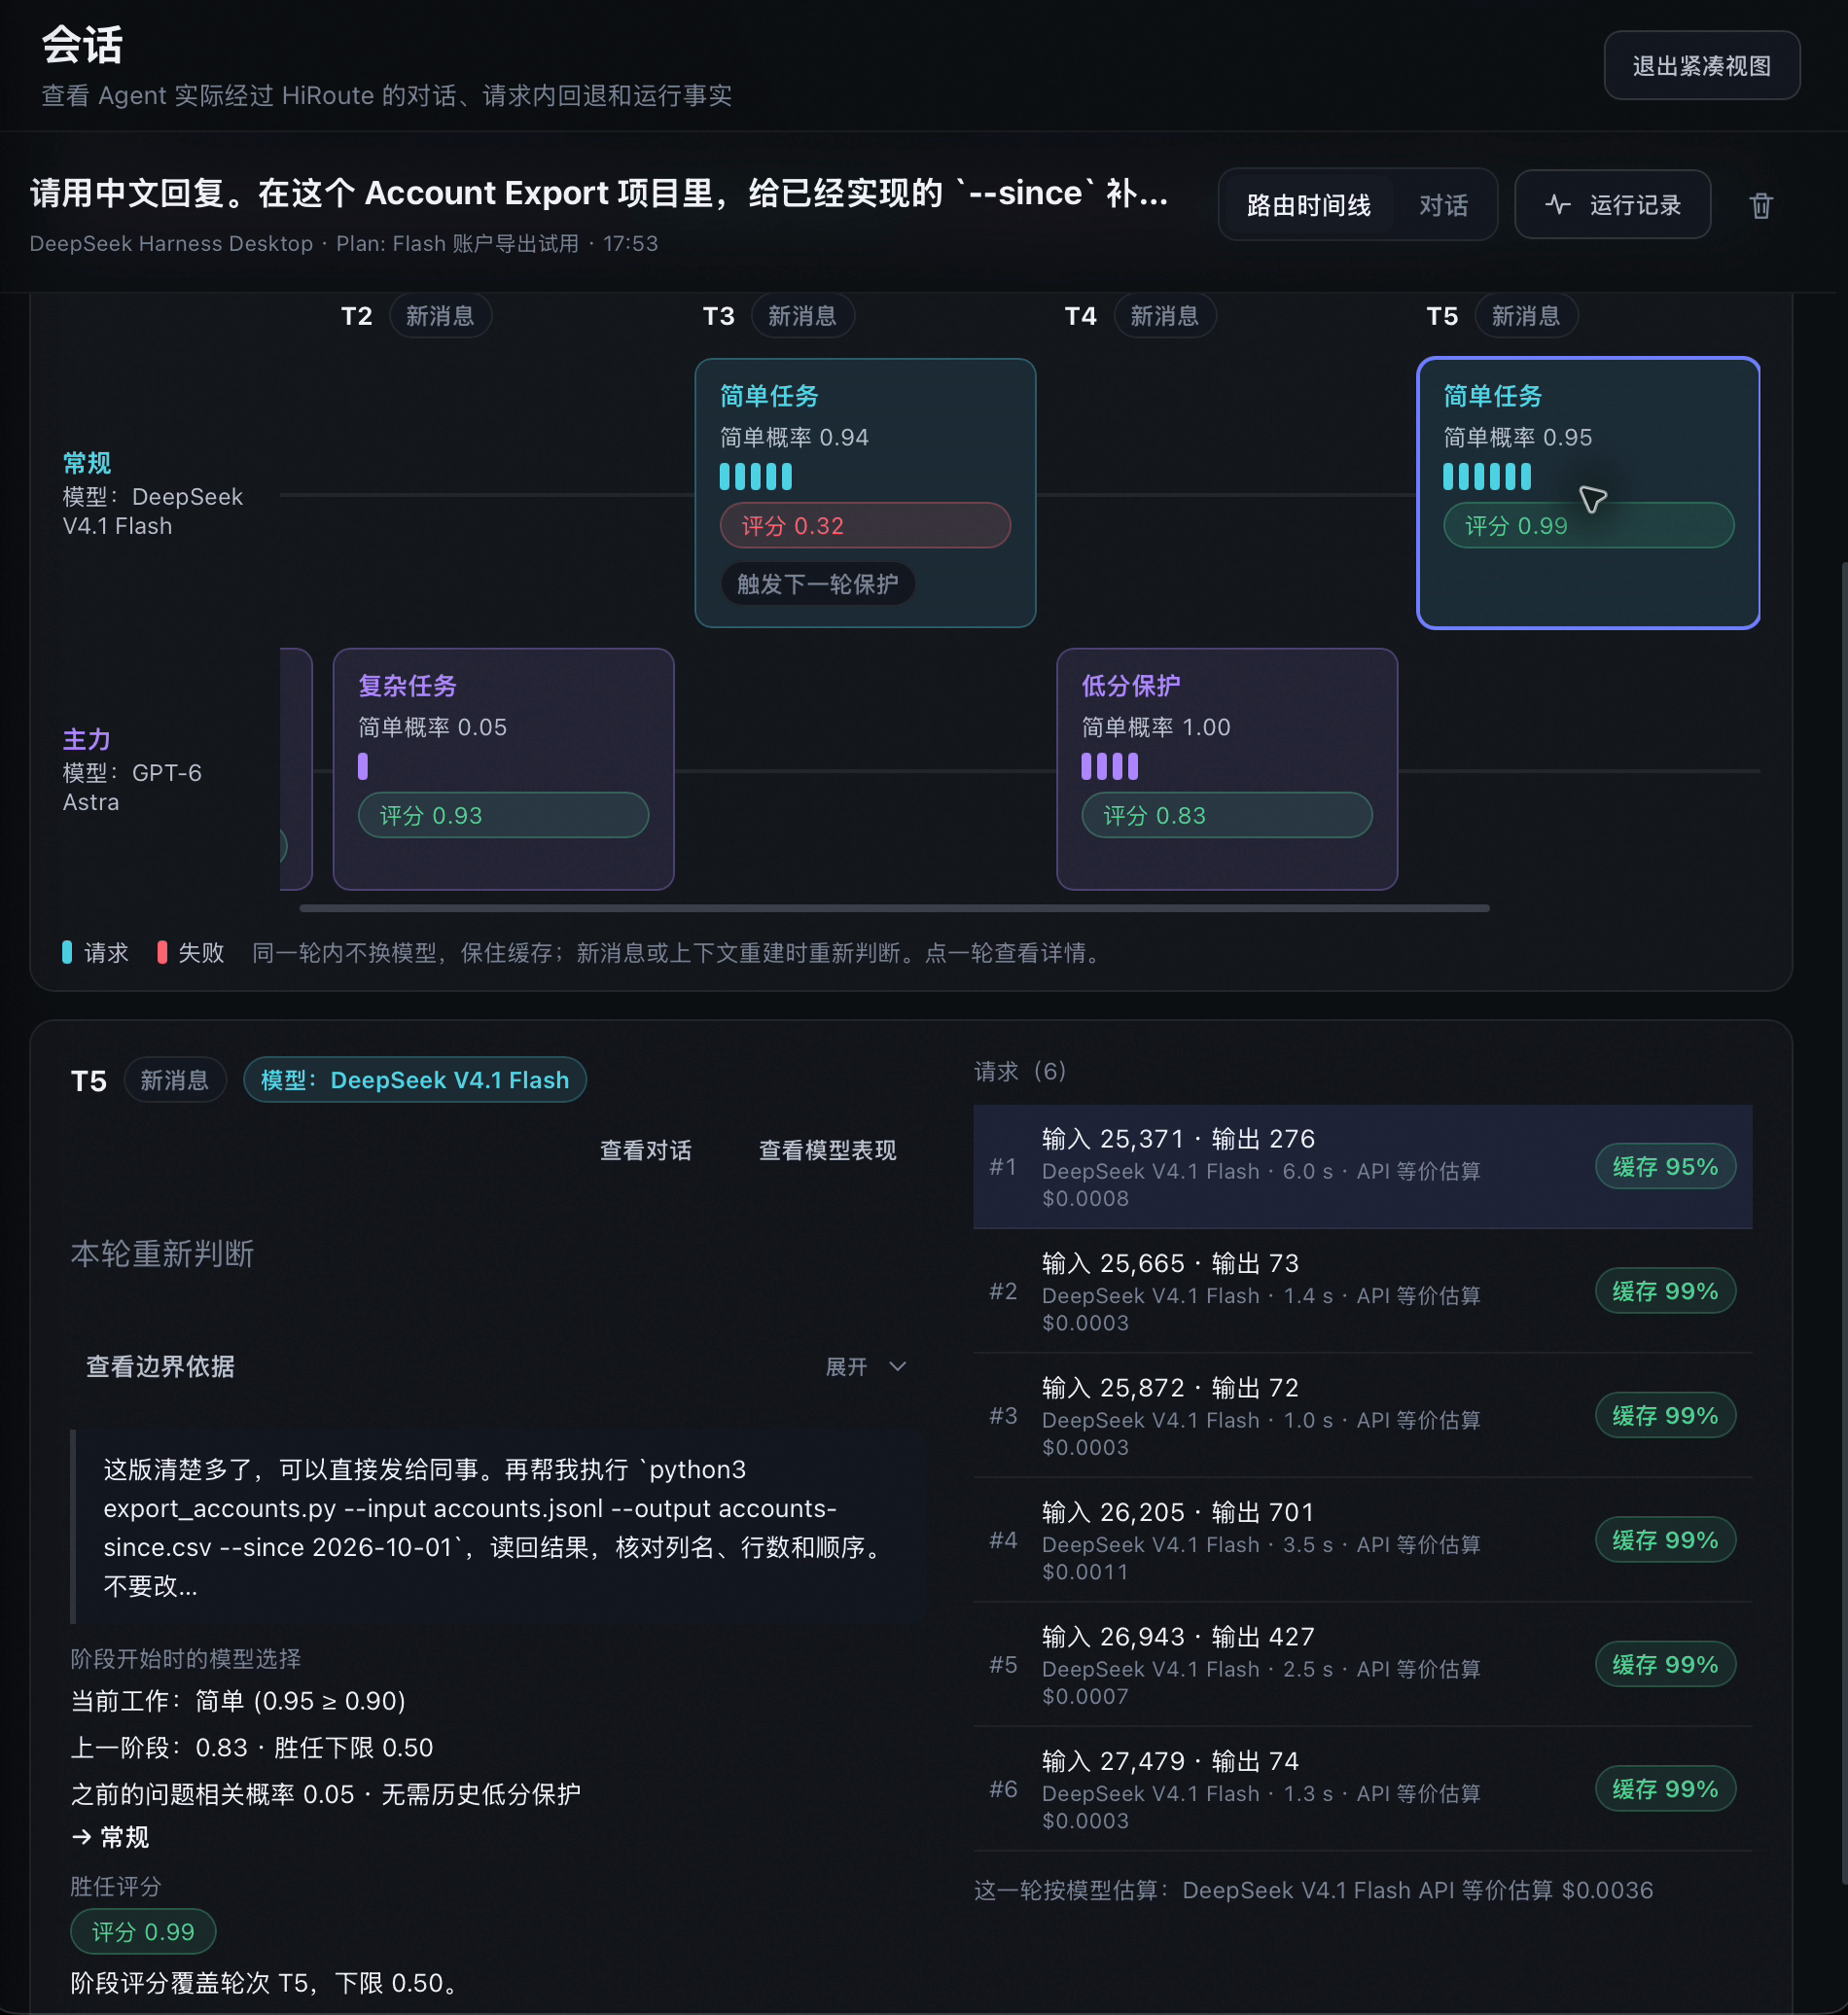
在路由的“模型表现”中,按实际任务分支、模型组、模型及思考设置查看阶段样本和胜任度覆盖。按难度分流按“常规 / 主力”分组;自定义分支按“写稿 → 常规 / 主力”等实际位置分组。同一模型用于不同组时分别记录。
打开阶段的“查看评分依据”或“阶段详情”,再定位会话证据,依次核对:
- 本轮选择:任务类别、简单概率、当时阈值、选中组及选择原因;没有复杂度判断时不适用,失败时不可用,都不能读作零概率。
- 实际执行:真正调用的模型、思考配置、组内候选位置,以及发生的故障接力。
- 后续评价:后一次决策对这个已执行阶段的评分、当时标准、评分覆盖与完整性;适用低分保护会指向它实际评价的旧阶段。
新草稿不能改写历史选择或阈值。未评分和部分证据应连同覆盖范围理解,HiRoute 不会根据一次低分自动改写计划。